UGTLDUGT LAB FOR DISCOVERY

修订:M90R · 2026-10-24(运行部署版本未核验)

从研究问题出发,逐步读懂候选证据。

本指南说明如何准备输入、沿项目导航查看证据,并形成可追溯的研究输出。它不收集账号凭据,也不把方法示意伪装成认证项目结果。

开始前:准备研究上下文

先核对研究问题、稳定身份和可用数据。资源缺失时记录缺口,不用假设值补齐。

问题与范围

目标物种、受体底物、拟比较的糖供体、候选范围和预期验证目标。

序列与标识

FASTA、稳定 Gene / Protein ID、来源数据库、版本及基因—蛋白映射。

结构与组学

结构来源与质量;表达矩阵、样本元数据、单位、归一化方式及标识映射。

五阶段研究路径

项目内部的导航围绕同一研究上下文组织。跨页面时核对 Project、Candidate、Species、Substrate、Donor、Analysis Run 和 Artifact。

01候选发现

浏览 UGT Table、系统发育与 Candidate Pool,检查身份和候选来源。

02证据分析

分别查看 Evolution、Structure 和 Biology 的证据状态与限制。

03综合判断

比较候选,独立查看 Coverage、System Priority 和 Researcher Decision。

04机制研究

按需要进入结构细节、反应几何或 Engineering;预测不等同于酶活。

05研究输出

核对候选范围、证据版本和来源,再查看报告或 Evidence Package。

关键工作台:只读浏览步骤

以下步骤依据当前项目的功能导航组织;准确控件名称和页面状态须以获批运行版本为准。未授权、不可用或缺失的数据必须保留其真实状态。不要为完成指南而提交候选、保存 Decision 或上传资源。

认证工作区截图缺口:NOT AVAILABLE / NOT VERIFIED

目前可复核的图像证据仅覆盖公开网站。未提供经批准的脱敏 UGT Table、Candidate Center、Structure 或 Biology 页面截图,因此这里不展示合成科研结果,也不声称这些页面已通过认证浏览器验收。下列“预期看到”是核对要点,不是某个项目的结果陈述。

01

浏览 UGT Table 并核对候选来源

当前所在
Project Workspace → 候选发现 → UGT Table。
操作
在项目导航选择“UGT Table”,使用页面当前提供的搜索或筛选查看目标记录。精确筛选器和按钮标签尚无认证截图可核验;不要依此指南推断未显示的控件。
为什么
确认稳定 Gene / Protein ID、Family、PSPG、序列注释和来源,避免把相似序列或未经确认的分组当作同一候选。
预期看到
当前项目的物种上下文、记录和已有注释来源。空列表、权限错误或缺失字段应原样记录,不用示例数据填充。
下一步
转到 Candidate Pool 核对当前项目范围。候选添加或批量保存属于写入操作,只能在获批可写环境中执行。
02

在 Candidate Center 区分证据与判断

当前所在
Project Workspace → 综合判断 → Candidate Center;Compare 用于并列查看候选。
操作
从当前项目导航进入 Candidate Center 或 Compare,先核对项目与候选身份,再查看各证据轴和当前已保存字段。仅使用页面确实显示的入口。
为什么
Evolution、Structure、Biology、Coverage、System Priority 和 Researcher Decision 表达不同事实,彼此不能推导。
预期看到
若权威数据存在,应显示各自状态与来源;若缺失,则保留系统给出的缺失状态。Coverage 不生成新排名,Decision 仅代表研究者记录。
下一步
按明确的证据缺口进入 Structure 或 Biology。Decision 保存属于写入操作,在 Review 只读环境下不要执行。
03

阅读 Structure 结果、方法与 Artifact 来源

当前所在
Project Workspace → 证据分析 → Structure Workspace。
操作
沿当前候选上下文打开 Structure 工作台,查找已有结构来源、质量指标、受体 / 供体条件、分析方法、结果及 Artifact / 原始文件入口。具体控件标签以实际运行页面为准。
为什么
区分实验结构与预测结构、RF2 与 Boltz-2、Donor-first docking 与其它分析,并区分任务状态和正式 Evidence Status。
预期看到
若有结果,应能核对结构身份、方法、Run、Artifact 与适用限制;若无结果,显示 NOT_RUN、FAILED 或 UNAVAILABLE 原因。任务完成不自动等于正式 Structure Evidence AVAILABLE。
下一步
沿同一候选与 Run 上下文返回 Candidate Center,仅对照其正式证据状态;本指南不启动新计算。
04

检查 Biology 的样本语境与数据来源

当前所在
Project Workspace → 证据分析 → Omics & Biology。
操作
从当前项目进入 Biology 工作台,核对实际提供的数据集、样本元数据、表达或通路结果及来源。Virtual KO/OE 只查看已有获准结果,不在此步骤新建任务。
为什么
表达解释依赖组织、处理、重复、单位、归一化和标识映射。缺失值不等于零表达,虚拟扰动不等于实验验证。
预期看到
真实数据应附样本条件、单位、方法与来源;若数据不可用,应显示原因,不能用模拟热图或零值填补。
下一步
回到 Candidate Center 核对 Biology 正式状态与来源。新增组学数据或重跑分析属于写入 / 计算,须另行获批。

创建研究项目

项目设置用于建立可追溯的研究上下文;它本身不会运行鉴定、对接或 Biology 计算。

适用场景

开始一个新的物种、底物或候选研究问题时使用项目向导。当前真实页面路由为 /#/app/projects/new。

开始前需要

  • 一个可识别的项目名称;研究问题可以后续补充。
  • 如果需要关联物种、底物、糖供体或数据,请确认它们已在当前目录登记。
  • 创建项目需要有效研究者会话和可写环境。只读 Review 会禁用创建,不会发送请求。

操作步骤

  1. 从 Research Workspace 进入 My Projects → New Project。
  2. 依次填写 Basics、Species、Research Goals、Candidate Source 与 Data Context;每一步只显示当前字段,切换时保留已填写内容。
  3. 用 Back 检查前面步骤,用 Save draft 保存到当前浏览器。草稿不是服务器项目。
  4. 提交前核对项目摘要;只有服务器返回真实 Project ID 后,创建才算成功。

结果与限制

成功创建后应进入对应项目;如果提示登录、权限不足、目录不可用或 Review 只读,按页面给出的状态处理。不要把本地草稿或静态成功提示当作已持久化项目。

本次实测状态:真实页面已在未认证会话中打开;显示需登录提示,创建未执行。已验证的是界面和只读保护,不是项目持久化。
查看批准的研究中心访问方式

底物与糖供体

Compound record 负责保存结构与来源语境;二维结构可解析不等于已完成对接配体准备。

输入与要求

优先使用有数据库来源或可校验 SMILES/SDF 的结构,并保留立体化学、结构标识、来源和标准化过程。将受体底物与 UDP-sugar donor 明确标记为不同角色。

操作与解释

  1. 在 Compound Workspace 使用当前可用的搜索、绘制或结构导入入口。
  2. 核对返回的结构身份和处理状态;保留原始结构与标准化结构的区别。
  3. 只有保存到获授权项目后,底物和供体才能作为项目上下文供后续分析读取。

局限与故障处理

数据库搜索失败时保留 provider 与错误状态,不要用静态缓存冒充实时命中。结构解析通过仅表示可解析,不表示质子化、原子类型或 Vina/Meeko 准备成功;应在 Analysis History 中核查具体配体准备任务和 Artifact。

查看公开资源目录与来源说明

解释候选证据与研究判断

候选身份、证据覆盖、系统优先级和研究者决策是不同数据,不应合并成一个“可信度”分数。

Coverage
表示证据轴的可用覆盖情况;缺失不是阴性结果。
Priority
已有系统优先级信息;不能从 Coverage 直接推导。
Researcher Decision
研究者单独记录的判断、理由和引用依据。

核对顺序

  1. 确认 Project、Species、Candidate 和底物身份。
  2. 对 Evolution、Structure、Biology 分别查看状态、来源、运行和适用性。
  3. 再核对 Coverage、Priority 与 Decision 的独立记录。
  4. 记录缺失、失败、不适用和未运行的区别,再决定下一步。

本公开指南不展示私有候选、优先级或决策结果。需要写入判断时,必须在授权的项目工作区内操作。

方法与数据边界

教程说明当前工作流的含义,不将可见路由或任务按钮解释为科研引擎已经完成验证。

  • UGT identification 需依赖真实 profile、执行日志和序列级证据;普通注释不自动等于家族鉴定。
  • Phylogeny 应保留输入、MSA/树工具版本和输出 Artifact。
  • Docking/model output 是计算证据,不是实验酶活测量。
  • Biology 解释依赖数据集版本、样本元数据、单位、归一化和 ID 映射。
  • 预测性 KO/OE 不证明真实生物因果关系;缺少组织元数据的数据集不支持组织特异性结论。

每个界面当前显示的状态、授权环境和具体任务 Artifact 优先于本教程中的一般步骤。

已验证的公开导航示例

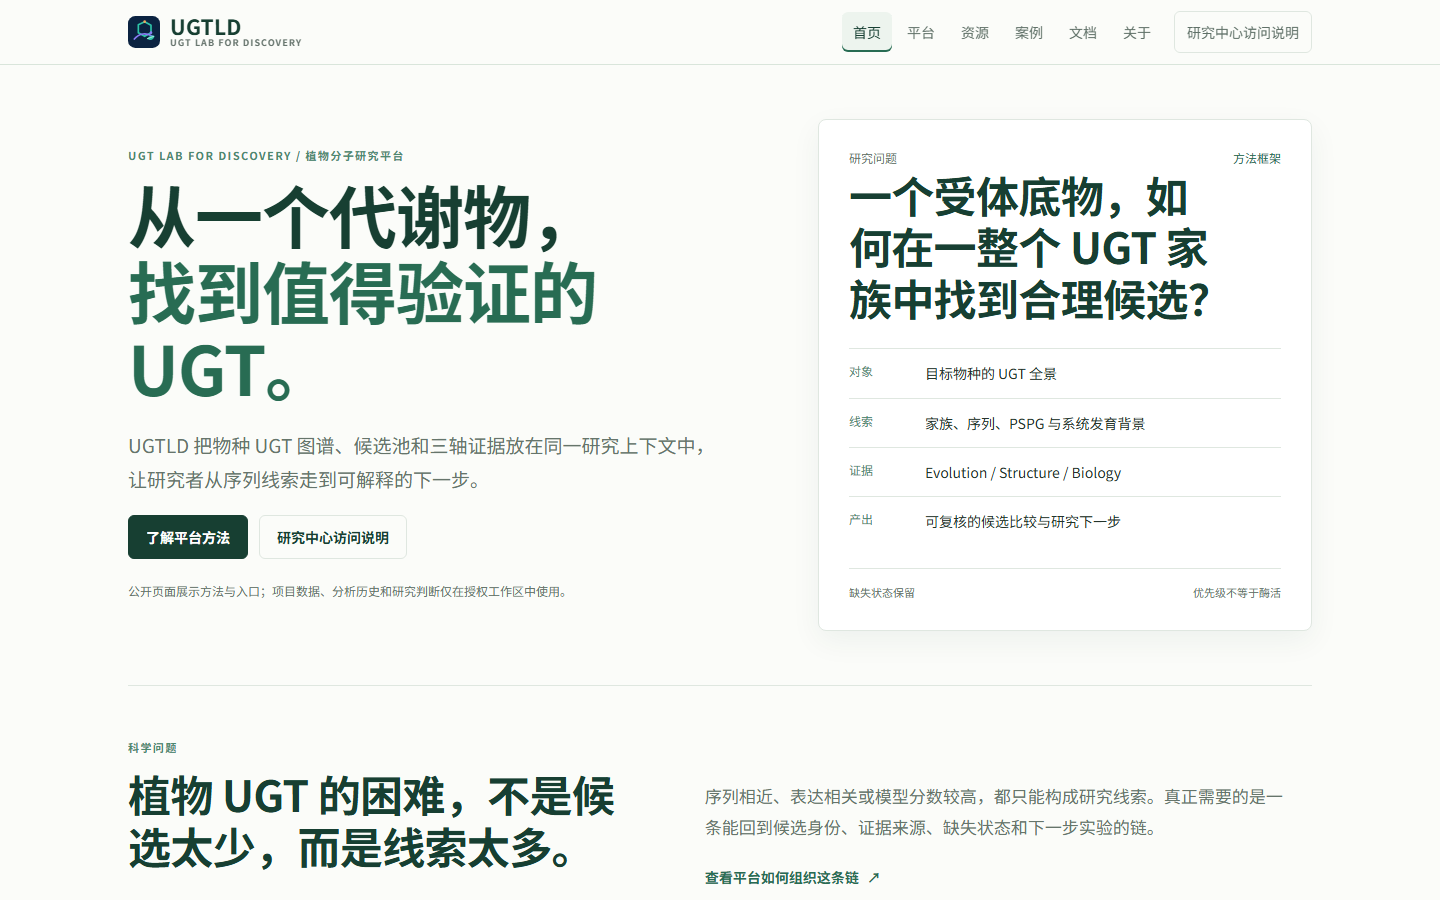
下图是公开页面在本地隔离浏览器中实际捕获的截图,只说明公开首页到 Platform 的导航,不是 Private Beta 页面、认证操作或真实研究项目数据。

UGTLD 公共首页的真实浏览器截图,显示了解平台方法入口
公开导航示例:位于 Public Home → 点击“了解平台方法” → 到达 Platform 方法总览 → 使用章节索引查看流程、模块与边界。此图不证明研究工作区可登录。

报告与导出前检查

导出的内容应与当前项目的候选中心一致,并保留范围、版本和缺口。

范围与来源

核对 Project、Candidate、Species、Substrate、Donor、Analysis Run、Evidence 和 Artifact 的身份、版本与权限。

状态与解释

确认 Coverage、Priority、Decision 独立,缺失与失败状态准确,方法限制和未验证项未被省略。

常见问题

具体可执行操作由当前环境权限决定;公开指南不取代项目授权或实验验证。

Coverage、Priority 和 Decision 有什么区别?

Coverage 表示证据覆盖,Priority 表示已有系统优先级信息,Decision 是研究者独立判断。三者不可互相推导。

为什么有候选但没有结构或生物学结果?

候选登记和证据可用性彼此独立。查看 Analysis History、输入契约、映射、Artifact 和适用性状态。

计算任务成功是否代表实验验证?

不代表。结构预测、对接、表达关联和虚拟扰动用于形成或检查假设,不替代体外酶活、产物鉴定等实验。

如何处理失败或不可用的证据?

保留失败 / 不可用原因、运行版本与日志;先核对输入和权限,再按授权流程决定是否重试。

教程状态:公开页面与参考资源可只读浏览;项目创建、候选保存、私有 Artifact 和分析运行需要授权会话。认证工作区截图仅在获得批准且脱敏后补充。